
Sempre di più l’Intelligenza Artificiale ci supporta nell’interpretazione di documenti o risponde a domande storiche su Google. Ma come interpreta la storia rispetto a noi umani?
di Fabio Celli da Chronos: Data Science e Storia del 6 settembre 2026
1. Large Language Models come storici
Non credo che l’Intelligenza Artificiale andrà a sostituire il lavoro degli storici, se è questo che state temendo. I Large Language Models (LLM) però sono uno strumento generativo: sono estremamente potenti per gestire, riassumere e distillare enormi moli di dati multimediali come gli archivi, e allo stesso tempo sono dei condensati di conoscenza creati da enti stranieri. Non usarli sarebbe un suicidio (anche perché rispondono alle domande storiche che gli studenti fanno sui motori di ricerca), ma dobbiamo conoscerli a fondo e capire come usarli al meglio. Sto dedicando una parte della mia linea di ricerca proprio a capire come questi strumenti interpretano la storia, come strutturare i prompt e cosa hanno di diverso rispetto agli umani. L’ultimo post che avevo dedicato a questo tema era La storiografia ai tempi dell’IA dove gli esperimenti mostravano che non tutti i LLM sono in grado di annotare la storia. I modelli più piccoli, con meno di 100 miliardi di parametri, tendono a “allucinare”, ovvero a generare informazioni malformate, imprecise o addirittura inventate. Al contrario, i modelli sopra i 400 miliardi di parametri, come GPT-4 e Llama3.1-405b, hanno dimostrato una precisione straordinaria, raggiungendo un livello di accordo nell’interpretazione della storia con la Structural Demographic Theory comparabile a quello tra due esseri umani.
Ho fatto ulteriori esperimenti. In particolare ho utilizzato tre LLM scelti a caso (Gemini 1.5, Claude 3.5 e GPT4) e tre annotatori umani non esperti di storia (degli studenti di informatica) per categorizzare un centinaio di decenni storici di diverse società a partire da brevi descrizioni di eventi. Come schemi interpretativi ho usato la Structural-Demographic Theory (Goldstone, Turchin) e il Big Cycle (Dalio). Le categorie da annotare erano le seguenti:
Structural Demographic Theory (SDT)
- Fase 0: Crisi, riforme o collasso.
- Fase 1: Coesione sociale (controllo sulle risorse e crescita)
- Fase 2: Impoverimento della popolazione (e arricchimento delle élite).
- Fase 3: Sovrapproduzione delle élite (e conflitto tra di esse)
- Fase 4: Stress dello Stato (e privilegi delle élite).
Big Cycle (BC)
- Fase 1: Crescita (basso debito alta produttività)
- Fase 2: Apice (costi crescenti e eccesso di debito)
- Fase 3: Declino (conflitto e svalutazione monetaria)
E i decenni storici da annotare erano descrizioni come queste: “1490-1499, Messico: re Ahuitzotl riformò l’alleanza tra città per ottenere più potere per gli Aztechi diventando il portavoce più anziano per distinguersi dai governanti di Texcoco e Tlacopan.”; 459-450 a.C., Roma: “la Repubblica Romana sconfigge gli Equi in una difficile battaglia sul monte Algido nominando Cincinnato dictator per risolvere la situazione. dopo avere vinto Cincinnato rimette il mandato dimostrando i valori della res publica”. Insomma un compito non facile.
2. Risultati
Ho dato le stesse istruzioni a umani e macchine in modo da avere risultati confrontabili. La grande novità è che ho anche chiesto di spiegare il perché delle scelte interpretative che hanno portato alla classificazione. Ecco uno schema dell’esperimento e i relativi risultati: inizialmente ho preso 60 esempi per ogni fase delle due teorie, e ho chiesto a Gemini di creare una descrizione Chiara di ciascuna fase che ho poi inserito in un prompt di istruzioni per l’annotazione delle fasi.
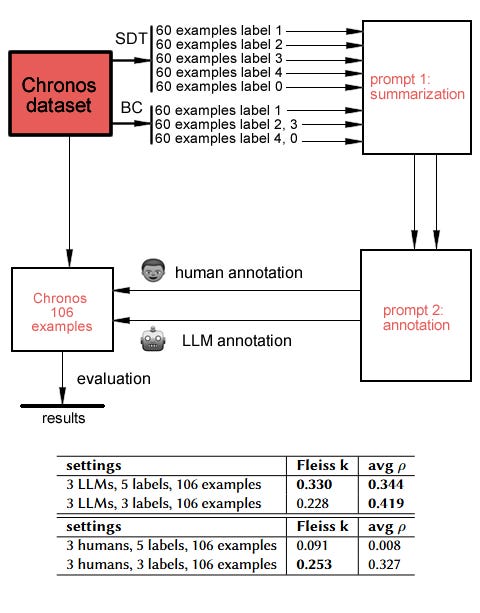
I risultati sono stati estremamente interessanti. Innanzitutto confermano che le prestazioni degli LLM nella classificazione sono paragonabili alle prestazioni umane. In particolare però i LLM si dimostrano molto più efficaci nel compito di classificazione a cinque categorie (Structural Demographic Theory) mentre gli esseri umani ottengono i risultati migliori nel compito a 3 etichette, (Big cycle) che è più semplice. In questo compito gli umani hanno un accordo (Fleiss k) leggermente più alto, ma i LLM battono gli umani in fatto di correlazioni. questo significa che gli umani sono d’accordo più sporadicamente, mentre i modelli sono d’accordo in maniera più consistente a livello temporale.
3. Causal slicing (come assegnare priorità nelle scelte interpretative)
Naturalmente, sia gli esseri umani che gli LLM commettono errori. Mentre gli esseri umani tendono a introdurre le proprie opinioni soggettive nell’interpretazione storica, dando priorità a fattori con cui hanno familiarità, come la politica e l’economia, i LLM (che hanno familiarità con tutto) tendono a selezionare le informazioni a cui dare priorità nella categorizzazione. questo fenomeno si chiama “causal slicing”, ovvero la “frammentazione delle cause”.
In pratica gli umani cercano di mappare le informazioni da interpretare su quello che sanno meglio. Infatti la maggior parte degli errori fatti dagli umani erano relativi ai decenni della repubblica romana, perché gli studenti tendevano a interpretare le guerre come segnali negativi e cercavano invece riforme economiche (a loro più familiari) come segnali positivi.
Invece i LLM hanno informazioni su tutto e le collegano tra loro, ma devono capire come dare priorità a informazioni talvolta discordanti. Con gli stessi dati di input, un LLM può attribuire maggiore importanza agli indicatori di sovrapproduzione dell’élite (ad esempio, l’espansione burocratica), mentre un altro può concentrarsi maggiormente sugli indicatori di impoverimento della popolazione (ad esempio, la definizione di uno status symbol riforme per mitigare disordini sociali), giungendo a conclusioni diverse.
Un esempio? Il decennio 690-699 a.C a Roma vede Numa Pompilio riformare diverse cose, tra cui l’istituzione di diversi culti (Terminus, Vesta e altri), la suddivisione della cittadinanza non più su base etnica ma su collegia opificum in base alle professioni (artigiani, carpentieri, ecc.), e la carica di pontefice massimo (sommo sacerdote della religione romana, riservata ai soli patrizi). Se un modello dà più importanza all’istituzione dei collegia opificum potrebbe essere portato a classificare con più probabilità come un impoverimento della popolazione, (interpretando le riforme come soluzione per un disordine sociale), mentre se dà più importanza all’istituzione di diversi culti, inclusa la carica di pontefice massimo, potrebbe interpretare più facilmente il decennio come una sovrapproduzione di élite.
Questi risultati hanno implicazioni significative per le discipline umanistiche digitali. Sebbene la competenza degli storici rimanga cruciale per le discussioni di storia pubblica, i LLM sono potenti strumenti che contengono al loro interno visioni storiche, e avranno certamente un impatto sulla società. gli esperimenti che ho descritto dimostrano che i LLM possono essere usati per annotare grandi insiemi di dati con la fase storica. Ciò apre le porte a un’analisi storica più estesa, riproducibile e basata sui dati, aiutando i ricercatori a ridurre i pregiudizi personali.
Tuttavia, dobbiamo essere consapevoli dei rischi. LLM addestrati su dati distorti o inaccurati possono diffondere disinformazione e omogeneizzare le narrazioni. Per affrontare questo problema, gli storici dovrebbero collaborare di più con esperti di IA. Le sfide sono sulla trasparenza delle annotazioni, su cosa sanno i modelli rispetto alla storia e sulla validazione di dati storici quantitativi e machine-readable. L’intelligenza artificiale offre un potenziale immenso, ma un’implementazione attenta è essenziale per massimizzarne i benefici e minimizzarne i rischi. […]